Геометрия неэргодических данных: как трансформеры строят байесовский вывод в виде телескопических конусов
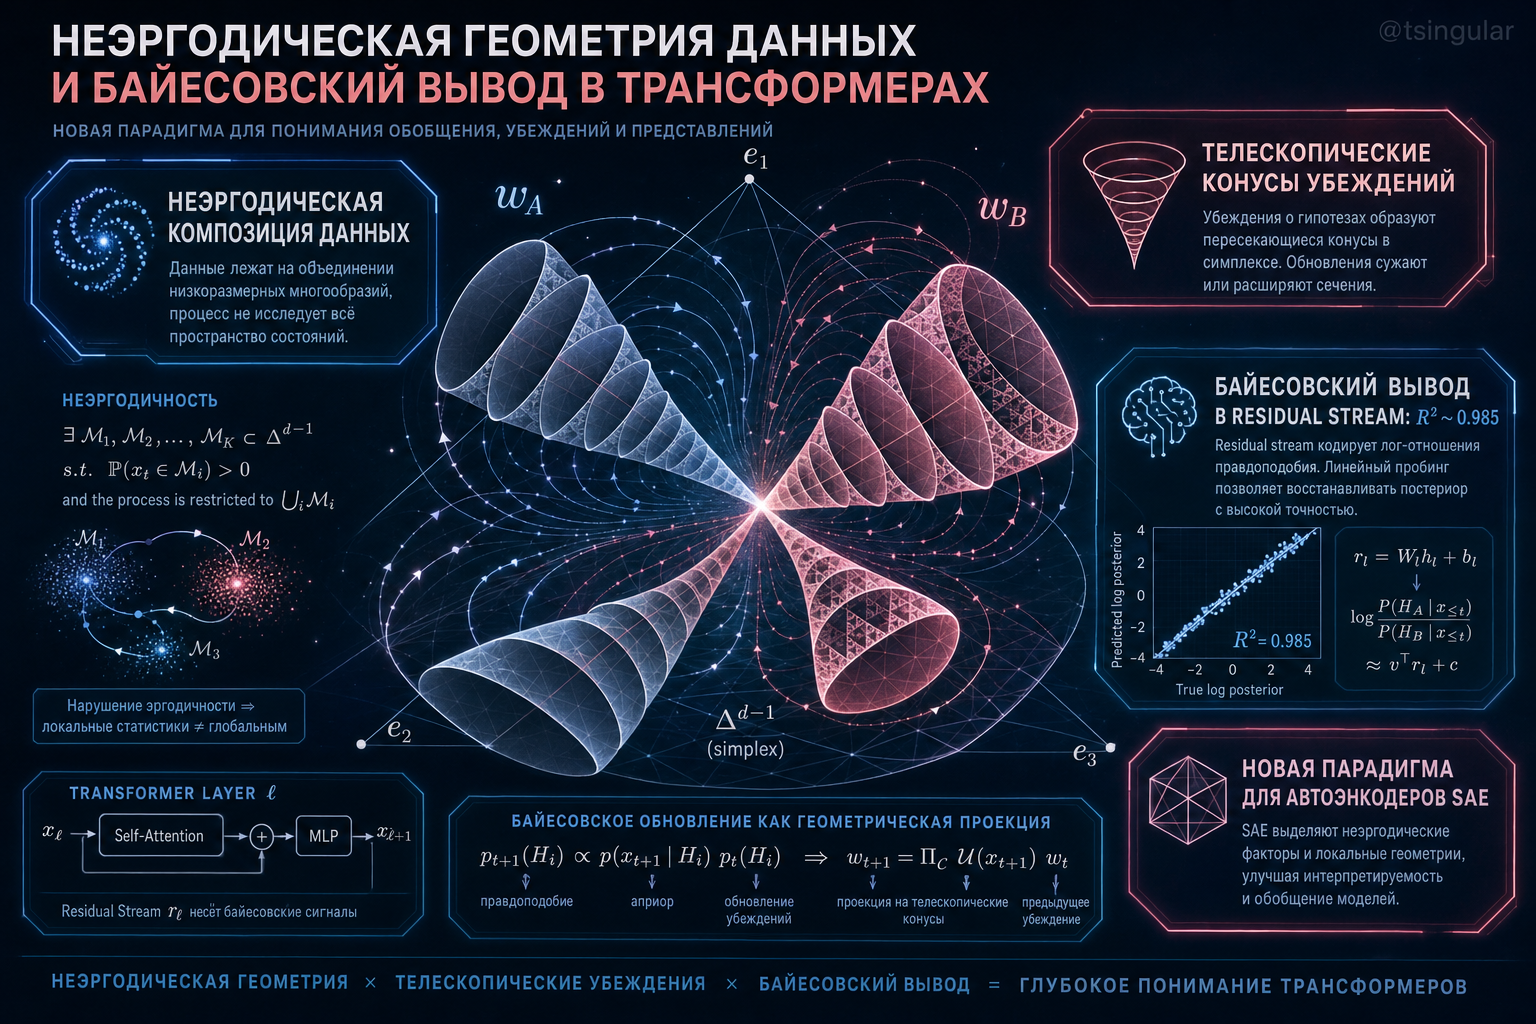
Исследователи из Simplex и института Astera опубликовали фундаментальную работу по интерпретируемости нейросетей. Они доказали и визуализировали форму активаций трансформера при обучении на разнородных текстах.
🎲 Датасеты LLM неэргодичны:
Корпус модели состоит из разнородных источников: посты на форумах, мануалы, договоры и статьи.
В теории вероятностей это неэргодическая композиция, - каждый текст порожден конкретным генератором, зафиксированным в документе. Фраза «Не делай…» может продолжиться и как совет в сети, и как инструкция к станку.
📐 Иерархический вывод и телескопические конусы:
При предсказании следующего токена модель решает две задачи одновременно:
• Оценивает вероятность того, какой генератор сейчас активен.
• Отслеживает внутреннее состояние внутри выбранного источника.
В пространстве убеждений это порождает структуру телескопических конусов. В начале контекста активны несколько подпространств. По мере чтения модель собирает свидетельства: конус истинного источника разворачивается, а конусы ложных гипотез схлопываются в точку.
🔬 Эксперимент на марковских моделях HMM:
Авторы обучили трансформер на смеси моделей HMM Mess3 и сняли активации остаточного потока. Линейный зонд восстановил теоретическую геометрию конусов с точностью R2 около 0.985. При этом сеть обучалась на обычное предсказание токена, - геометрия возникла спонтанно.
💡 Новая парадигма для автоэнкодеров SAE:
Популярный подход ищет одномерные разреженные фичи. Работа доказывает иной принцип: для неэргодических данных естественны разреженные плотные подпространства. Внутри активного источника пространство многомерно, а разреженность возникает между источниками.
#интерпретируемость #трансформеры #машинноеобучение #геометрия #исследования
———